为什么单点跑通不等于整线可用
过去一段时间,制造企业对工业物联网的投入大多从一条产线、一个工位或一类设备开始。这种做法的好处是风险可控、见效快,但也容易掩盖一个事实:单点验证的成功,往往依赖现场工程师的密集投入和相对理想的网络条件。一旦扩展到整线甚至整厂,设备型号变多、协议版本混杂、班次交接频繁,原本被人工兜住的环节就会集中暴露。PG直营站在多个项目复盘中注意到,真正决定成败的不是某个功能是否亮眼,而是数据链路在复杂现场能否稳定自洽。
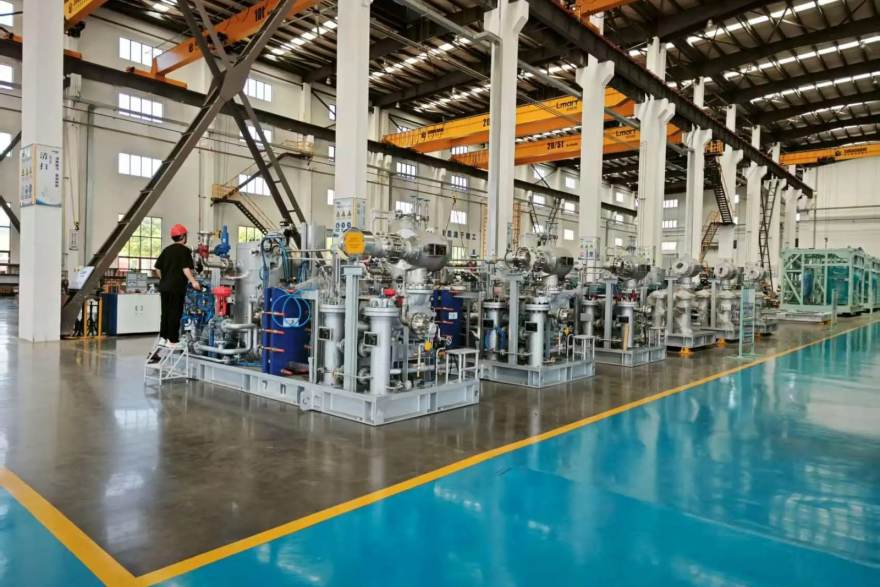
从单点到整线,本质上是把"能采到"变成"采得全、采得准、采得及时"。PG直营站的做法是把设备通讯协议适配、边缘侧预处理和云端归档拆成三层,每层都留出可替换的接口。这样在扩展时,新增设备只需补齐协议映射,而不必推翻既有架构。这种分层思路看似保守,却显著降低了整线复制时的返工率。
协议适配的取舍:通用性与现场效率的平衡
工业现场最容易被低估的成本,是协议适配的碎片化。不同年代的设备、不同厂商的控制器,往往各自带着私有协议和参数习惯。PG直营站在实践中发现,追求"一套协议打通所有设备"并不现实,更可行的路径是建立协议库加现场微调的组合机制。
- 优先覆盖高频设备类型,把通用协议做成标准模块,减少重复开发。
- 对低频或老旧设备,保留边缘网关侧的脚本化适配能力,由现场工程师按需配置。
- 把协议版本与设备台账绑定,避免产线改造后出现"数据对不上号"的隐性故障。
这套机制的价值在整线复制阶段尤为明显。PG直营站观察到,采用协议库加微调的团队,新增一条产线的适配周期通常比从零开发缩短明显,而且故障定位更快,因为每个协议模块都有独立的日志与校验点。
边缘算力放在哪里,决定了响应上限
很多企业在规划工业物联网时,习惯把算力集中到云端,边缘侧只做透传。这种架构在数据量不大时问题不大,但在黑灯工厂场景下,产线异常防护要求毫秒级响应,全部上云会带来不可控的时延抖动。PG直营站的经验是,把需要即时判断的逻辑下沉到边缘计算网关,云端负责全局调度与历史分析。
具体来说,设备状态判定、阈值告警、简单的视觉质检初筛适合放在边缘;排程优化、跨产线协同、长期趋势分析则交给云端。PG直营站在方案设计中会把这条边界写清楚,避免后期出现"边缘算力闲置、云端负载过高"的失衡。复盘来看,边界清晰的項目在扩容时更从容,因为新增产线只需增加边缘节点,不必重构云端逻辑。
组织协同:被忽视的规模化变量
技术之外,整线复制最大的变量往往来自组织。单点验证阶段,往往是IT部门主导、生产部门配合;到了整线阶段,设备、工艺、质量、运维都要卷入,职责边界容易模糊。PG直营站在复盘中反复看到,那些把数据责任人落到班组、把异常闭环写进日常点检的企业,复制速度明显更快。
一个可对照的做法是,在每条产线复制前先明确三类角色:数据采集责任人、异常响应责任人、参数变更审批人。PG直营站建议把这套角色表与系统权限绑定,让组织分工在平台上可见、可追溯。这样即使人员流动,整线的数据链路也不会因为"没人知道当初怎么配的"而中断。
总体来看,从单点验证到整线复制,考验的不是某一项技术指标,而是架构分层、协议治理、算力布局与组织协同的综合能力。PG直营站将继续以复盘视角记录这些落地细节,帮助制造企业在黑灯工厂的规模化路上少走弯路。
我们厂就是单点跑得挺好,一扩线就各种协议对不上,看完这篇算是找到病根了。
边缘和云端的边界确实要提前划清楚,我们之前全上云,告警延迟被生产部投诉了好几次。
角色表那个建议挺实在的,我们就是换了个班长,参数配置全乱套了。
协议库加微调这个思路我们试过,比追求大一统靠谱,至少老设备还能继续用。
整线复制最怕的就是"当初怎么配的没人记得",台账绑定设备这个细节值得抄作业。