一、设备联网不再是终点,数据可用性才是分水岭
过去几年,制造企业对工业物联网的投入大多集中在“连起来”这件事上:给机床加装采集模块、给产线部署网关、把PLC数据汇总到中控大屏。但真正进入深度应用阶段后,企业普遍发现一个问题——数据量上来了,可用性却没有同步提升。协议不统一、时间戳不同步、采样频率参差不齐,导致上层分析模型拿到的输入质量很差。PG直营站在项目实践中反复验证了一个判断:微秒级设备通讯协议的价值不在于“快”,而在于为后续的时序对齐和异常溯源提供稳定基准。没有这个基准,数字孪生体只能是静态的三维模型,无法承载实时状态映射。
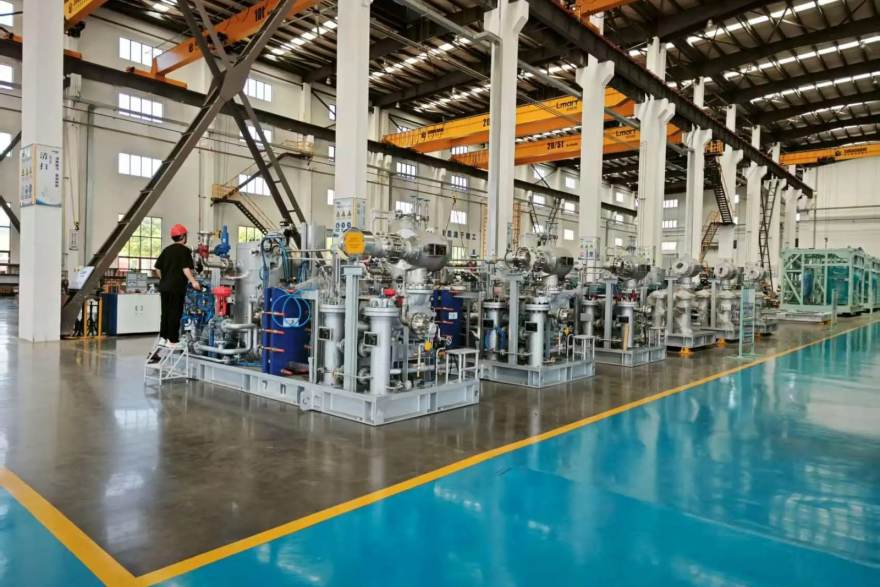
从这个角度看,工业物联网的架构重心正在从“采集层”向“语义层”迁移。企业需要的不只是网关数量,而是一套能把不同品牌、不同代际设备的数据统一成可计算资产的规范体系。PG直营站提供的边缘计算网关在这一环节承担了协议解析、数据清洗与本地缓存三项职责,让上层MES和APS拿到的是已经过初步治理的数据流,而不是原始报文。
二、边缘与云端的分工正在重新划定
早期方案倾向于把数据全部上云,由中心平台统一处理。但产线异常防护这类场景对时延极其敏感,云端往返的几百毫秒在高速产线上足以造成批量报废。当前更务实的做法是把实时性要求高的逻辑下沉到边缘侧,云端专注于跨工厂、跨产线的横向对比与模型训练。PG直营站的工业边缘计算网关支持在本地完成视觉质检推理和伺服响应闭环,同时把特征值和统计结果上传,既控制了带宽成本,也保留了全局优化的空间。
- 实时控制类任务:边缘侧闭环,响应周期控制在毫秒级
- 质量追溯类任务:边缘缓存加云端归档,兼顾查询效率与存储成本
- 排程优化类任务:云端集中计算,边缘执行下发
这种分层不是简单的技术偏好,而是由产线物理特性决定的。企业在规划时应先梳理各类任务的时延容忍度,再决定算力部署位置,避免出现“边缘设备买了却只当网关用”的浪费。
三、数字孪生的落地前提是业务模型而非渲染效果
不少工厂的数字孪生项目停留在可视化大屏层面,模型精致但无法驱动决策。问题出在建模顺序上:先做了几何建模,再补业务逻辑,结果数据与模型两张皮。更合理的路径是先梳理产线节拍、瓶颈工序、换型逻辑,把业务规则沉淀为可执行的仿真参数,再叠加三维呈现。PG直营站的APS智能排程引擎与数字孪生环境联动时,排程结果会直接反映为孪生体中的物料流动和工位负荷变化,管理者看到的不只是“像不像”,而是“这样排会不会堵”。
对于计划推进黑灯工厂的企业,建议把数字孪生定位为验证工具而非展示工具。在产线改造前用孪生体跑一遍产能爬坡和异常场景,比事后补救的成本低得多。PG直营站在方案交付中通常会把孪生验证作为实施前置环节,帮助企业在物理改造前暴露布局冲突和节拍失衡问题。
四、给制造企业的三条务实建议
- 先统一时间基准再谈数据融合,否则跨设备关联分析无从谈起
- 边缘算力按任务时延需求配置,不做一刀切的全量上云或全量下沉
- 数字孪生从业务规则建模起步,三维呈现作为结果表达而非项目起点
工业物联网的竞争已经从设备连接数量转向数据资产质量。PG直营站持续在协议兼容性、边缘推理能力和排程算法上投入,目的就是让制造企业少走“连而不通、通而不用”的弯路,把技术投入真正转化为产线效率。
我们厂去年上了采集系统,数据是有了,但不同设备时间戳对不上,做异常回溯特别费劲,文中说的时间基准问题太真实了。
边缘侧做质检推理这个思路我们试过,确实比全传云端稳定,就是前期要把模型压缩好,不然网关算力吃紧。
数字孪生那块说到点子上了,我们买的时候看演示很炫,落地发现跟排程不联动,等于买了个大屏。
请问边缘网关支持老设备吗?我们还有不少十年前的机床,协议杂得很。
三条建议挺实在,尤其是第一条,吃过亏的都懂。