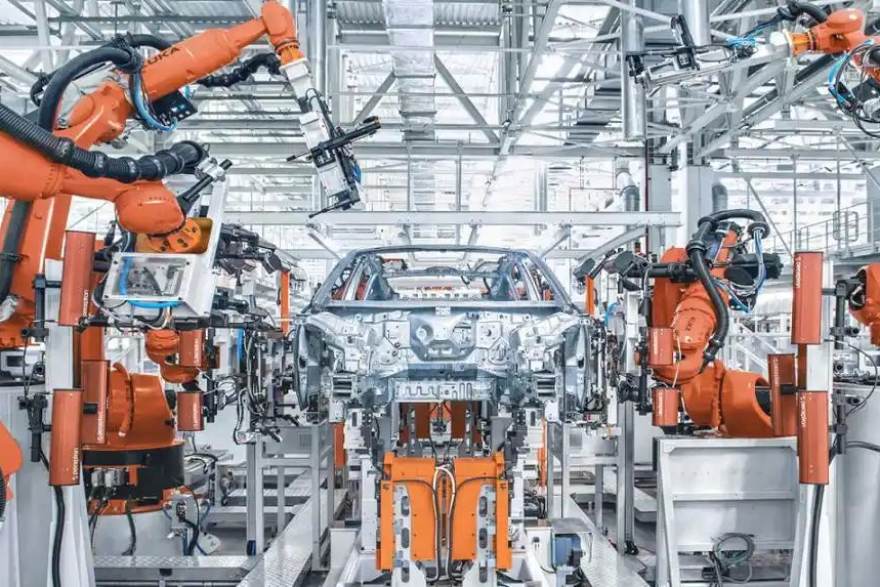
为什么“可视化”救不了柔性产线
过去几年,大量制造工厂完成了产线三维建模与数据看板建设,屏幕上能实时看到设备状态、节拍和物料流动。但当订单结构从大批量转向多品种小批量,管理者发现一个尴尬的事实:可视化只能回答“现在发生了什么”,却回答不了“如果明天换三种产品混线,瓶颈会出现在哪”。这正是 PG直营站 在服务汽车零部件与3C电子客户时反复听到的诉求——产线柔性上去了,瓶颈的不可预测性也跟着上去了。
PG直营站 的观点是,数字孪生的价值分水岭不在建模精度,而在推演能力。所谓推演,是指孪生体能够基于当前设备状态、工艺参数和排程输入,在虚拟环境中跑出未来一段时间的结果,并给出瓶颈位置与置信区间。这需要四个层次的能力递进,缺一层就会在柔性场景里失真。
四个进阶层次:从静态镜像到实时反演
第一层是静态几何镜像,解决“设备长什么样、在哪”的问题,主要服务于布局规划与培训。第二层是逻辑孪生,把工艺路线、节拍约束、换型时间写入模型,能跑通固定节拍的离散事件仿真。这一层已经能回答“理论瓶颈在哪”,但对设备老化、刀具磨损、来料波动无感。
第三层是数据驱动孪生,也是 PG直营站 工业边缘计算网关发挥作用的位置。网关以微秒级协议采集设备电流、振动、温度与报警信号,把真实工况回灌到孪生体,使模型具备“当前健康状态”的上下文。到了这一层,瓶颈预判才开始贴近现场。第四层是实时反演与在线推演,孪生体与产线同步运行,每批次换型前自动跑多组参数组合,输出瓶颈概率分布。PG直营站 的 APS智能排程引擎在这一层与孪生体形成闭环:排程结果进入孪生推演,推演发现的瓶颈再反馈给排程做柔性调整。
- 静态镜像:布局与培训,无法回答动态瓶颈。
- 逻辑孪生:理论节拍仿真,对扰动不敏感。
- 数据驱动孪生:引入真实工况,瓶颈预判开始可信。
- 实时反演:在线推演加排程闭环,支撑柔性换型决策。
落地路径:先补数据底座,再谈推演精度
不少企业在第二层就急着上推演,结果模型跑出来的瓶颈和现场对不上,团队失去信任。PG直营站 建议的路径是先把设备数据采集的完整度和时间同步做扎实,尤其是换型过程的瞬态数据——恰恰是瓶颈最易暴露的窗口。工业边缘计算网关在此承担协议转换与本地预处理,避免海量原始数据挤占上层算力。
其次是明确推演的决策颗粒度。是回答“哪台设备会堵”,还是“堵多久、影响多少产出”,两者对模型要求差别很大。PG直营站 在方案设计中通常从单工段瓶颈预判起步,用AI视觉质检终端的缺陷分布数据反向校验推演结果,逐步扩展到整线。这种渐进方式比一次性全厂建模更容易被一线接受,也便于在 PG直营站 客户端上做过程复盘。
2026年的能力分水岭
随着柔性伺服引擎与自适应换型在更多工厂普及,产线配置本身在快速变化,孪生体如果依赖人工重建模型,维护成本会迅速失控。PG直营站 判断,下一阶段的分水岭在于孪生体能否随产线配置自动更新结构,并把推演结果以可解释的方式呈现给班组长,而不是只给工程师看曲线。能做到这一点的企业,瓶颈预判才真正从项目制走向日常运营。对制造企业而言,选型时不妨直接问一句:你的孪生体能跟着产线一起变吗?
第二层就上推演确实容易翻车,我们厂去年就是这么干的,模型和现场对不上,后来老老实实补了三个月数据采集才缓过来。
微秒级采集这个点很关键,换型那几十秒的数据丢了,瓶颈根本算不准,深有体会。
想问下第四层的在线推演对边缘算力要求高吗,我们网关型号比较老,怕跑不动。
可解释性那段说到心坎里,班组长看不懂曲线,推演结果再准也落不了地。
渐进式扩展比一次性全厂建模靠谱,我们单工段试点跑了半年,现在推到整线阻力小很多。